
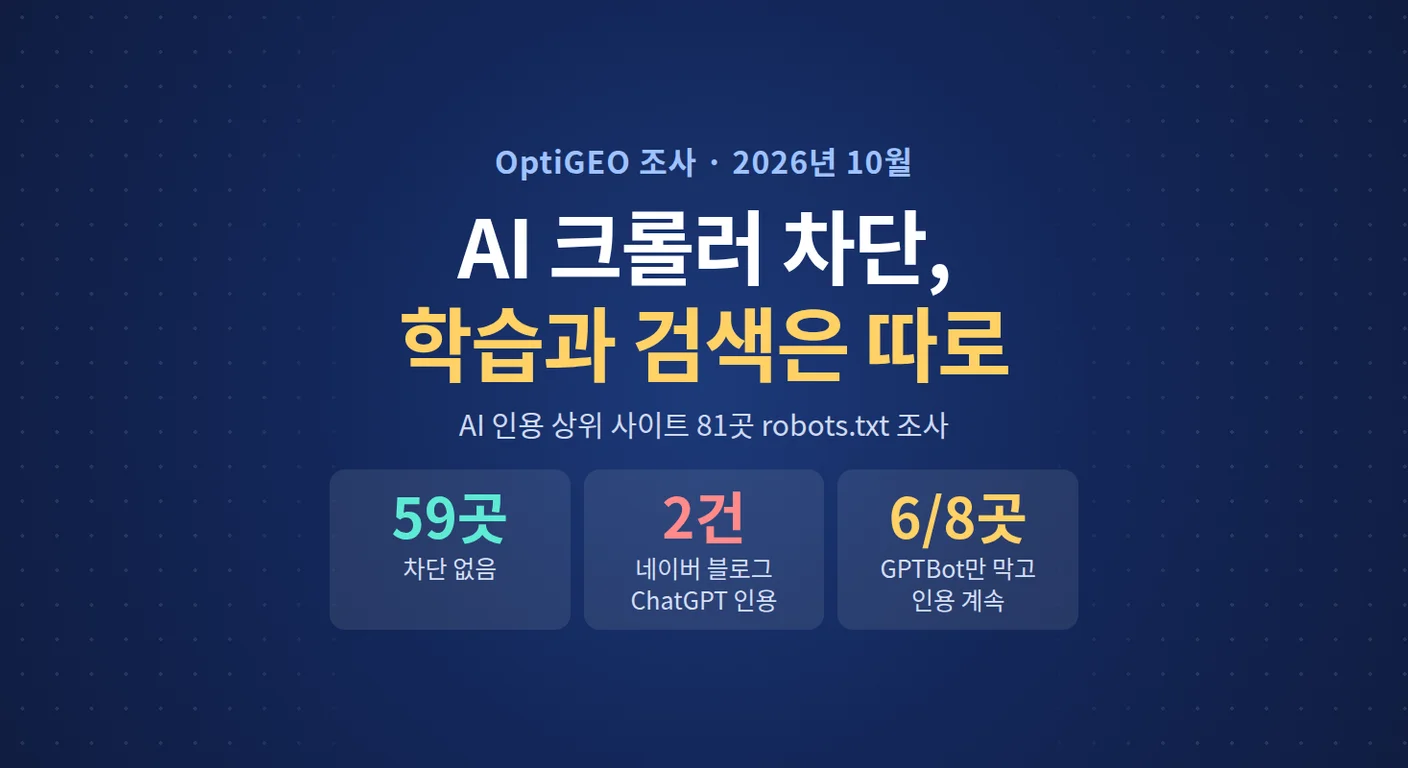
AI 크롤러를 robots.txt에서 모두 막으면 AI 학습뿐 아니라 AI 검색 답변에 인용될 기회도 함께 줄어들 수 있습니다. AI가 자주 인용하는 사이트 81곳의 robots.txt를 조사한 결과, 검색용 크롤러를 막은 네이버 블로그는 ChatGPT 인용이 거의 없었고, 학습용 크롤러만 막은 언론사는 계속 인용되었습니다. 학습과 검색 노출은 따로 설정할 수 있습니다.
사이트 상위 100곳 중
robots.txt를 읽은 81곳
OptiGEO 측정, 로그인하지
않은 상태
RFC 9309 규칙 적용
AI 크롤러는 용도에 따라 어떻게 나뉩니까?
AI 크롤러는 학습용, 검색용, 사용자 요청형 세 가지로 나뉩니다. 학습용은 모델 학습 자료를 모으고, 검색용은 AI 검색 답변에 보여 줄 페이지를 색인하며, 사용자 요청형은 대화 중 질문을 받으면 그 순간 페이지를 읽어 옵니다.
- OpenAI
GPTBot - Anthropic
ClaudeBot - Google
Google-Extended*
- OpenAI
OAI-SearchBot - Anthropic
Claude-SearchBot - Perplexity
PerplexityBot - Google
Googlebot
- OpenAI
ChatGPT-User - Anthropic
Claude-User - Perplexity
Perplexity-User
OpenAI는 크롤러별 설정이 서로 독립적이라고 설명합니다. GPTBot을 막아도 OAI-SearchBot이 허용되어 있으면 ChatGPT 검색 답변에는 계속 나올 수 있습니다. Perplexity는 PerplexityBot을 AI 기반 모델 학습용 수집에 쓰지 않는다고 밝힙니다.
실제 사이트는 어떤 크롤러를 막고 있습니까?
대부분은 아무것도 막지 않았습니다. 81곳 중 59곳(73%)은 AI 크롤러를 하나도 막지 않았습니다. 막은 곳은 학습용 크롤러를 검색용보다 두 배 가까이 많이 막았습니다.
검색용 크롤러를 막으면 인용이 사라집니까?
검색용 크롤러를 막은 사이트는 해당 AI에서 거의 인용되지 않았습니다(차단 시점을 확인하지 못한 2곳 제외). 네이버 블로그·카페·뉴스·지식iN·프리미엄콘텐츠 5곳은 OAI-SearchBot을 막고 있습니다. 네 AI가 이 5곳을 인용한 6,996건 중 ChatGPT 인용은 3건(0.04%)이었습니다. 반대로 OAI-SearchBot을 허용한 74곳에서는 23,639건 중 6,713건(28%)이 ChatGPT 인용이었습니다.
User-agent: OAI-SearchBot
User-agent: Google-Extended
User-agent: ClaudeBot
User-agent: PerplexityBot
Disallow: /
학습용만 막은 사이트는 결과가 달랐습니다. GPTBot은 막고 OAI-SearchBot은 허용한 8곳 중 6곳을 ChatGPT가 계속 인용했습니다.
| 사이트 | ChatGPT 인용 | AI 4종 전체 |
|---|---|---|
| 연합뉴스 | 175건 | 210건 |
| 브런치스토리 | 29건 | 159건 |
| 위키독스 | 20건 | 191건 |
| 로톡 | 15건 | 633건 |
| 조선비즈 | 10건 | 100건 |
| 매일경제 | 9건 | 112건 |
GPTBot 차단 · OAI-SearchBot 허용 사이트 중 ChatGPT 인용이 있었던 6곳. 나머지 2곳은 0건입니다.
robots.txt는 조사일 기준이고 인용은 그 이전 기간이라, 최근에 설정을 바꾼 사이트는 결과가 섞일 수 있습니다. 실제로 증권사 2곳은 현재 OAI-SearchBot을 막고 있지만 8월까지 ChatGPT 인용이 있었고, 차단 시점을 확인하지 못해 위 비교에서 제외했습니다.
Google-Extended를 막으면 무엇이 달라집니까?
Gemini 앱의 인용이 줄고, 구글 AI 모드 인용은 유지됩니다. Google은 Google-Extended가 Gemini 학습과 Gemini 앱의 답변 근거 활용 여부를 정할 뿐, 구글 검색 포함 여부에는 영향을 주지 않는다고 밝힙니다. 조사에서도 Google-Extended를 막은 사이트는 Gemini 인용이 거의 없었고 AI 모드 인용은 있었습니다. 다만 차단 11곳 중 7곳이 네이버·증권사 사이트여서 사이트 성격의 영향을 따로 떼어 볼 수는 없습니다.
구글 AI 기능에 보이는 내용을 줄이려면 Google-Extended가 아니라 nosnippet, max-snippet, noindex 같은 기존 검색 제어 방법을 씁니다.
학습만 막고 AI 검색 노출은 어떻게 유지합니까?
학습용은 전체를 막고, 검색용은 허용하되 원래 막던 경로를 그룹마다 다시 적습니다. 크롤러는 자기 이름이 적힌 그룹이 있으면 그 그룹만 따르고 User-agent: * 그룹은 무시하기 때문입니다.
# 1) 학습용 — 전체 차단
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

# 2) 검색용 — 허용, 기존 차단 경로는 다시 적기
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow: /admin/
Allow: /

# 3) 나머지 전체
User-agent: *
Disallow: /admin/
예시의 /admin/은 각 사이트에서 실제로 막고 있는 경로로 바꿔 적습니다. 이 경로를 빠뜨리면 이름을 적은 크롤러에는 관리자 화면까지 열립니다.
설정한 뒤 무엇을 점검합니까?
설정 뒤에는 네 가지를 확인합니다.
- 반영 시간 — OpenAI는 ChatGPT 검색 결과 반영에 약 24시간이 걸릴 수 있다고 안내합니다.
- 주소별 파일 — robots.txt는 같은 호스트에만 적용됩니다. www가 붙은 주소와 붙지 않은 주소를 각각 확인합니다.
- 서버 오류 — 네이버 검색로봇(Yeti)은 robots.txt 요청이 5xx 오류로 끝나면 모두 허용하지 않음으로 해석합니다.
- 사용자 요청형 — ChatGPT-User·Perplexity-User는 robots.txt를 따르지 않을 수 있습니다. 꼭 막아야 할 페이지는 로그인으로 보호합니다.
학습 차단과 AI 검색 노출은 따로 정합니다. 검색용 크롤러까지 막으면 그 AI의 답변에서 인용이 사라질 수 있으므로, 크롤러별 용도를 확인하고 회사 방침에 맞게 하나씩 설정합니다. 먼저 자사 robots.txt에서 OAI-SearchBot·Claude-SearchBot·PerplexityBot이 막혀 있는지 확인합니다.
이 글은 2026년 10월 기준 각 기업의 공식 문서와 OptiGEO 조사 결과를 바탕으로 작성했습니다. 크롤러 이름과 정책은 바뀔 수 있으므로 설정 전에 원문을 다시 확인하시기 바랍니다.
참고 자료
- OpenAI — Overview of OpenAI Crawlers
- Google Search Central — Google의 일반 크롤러(Google-Extended)
- Google Search Central — AI features and your website
- Anthropic — Does Anthropic crawl data from the web?
- Perplexity — Perplexity Crawlers
- IETF — RFC 9309 Robots Exclusion Protocol
- 네이버 서치어드바이저 — robots.txt 설정하기